给每一次失败一个确定的归宿:ElecCloud 两级重试设计
凌晨两点十七分,一笔退款请求返回了 504。
调用方已经按下重试,业务方在群里问这单为什么还没到账,而真正需要被问出口的那个问题,此刻还没有人说:这条已经发出、可能已经在对方系统里生效、又可能根本没落地的请求,眼下到底算什么状态?
做过后端的人都熟悉这个瞬间。它不刺激,不戏剧,只是安静地卡在某个地方,然后被各种临时手段一路推着往前,直到某天推不动了。
一、重试是最容易写错的十行代码
先把最常见的那十行摆出来:
for (int i = 0; i < 3; i++) {
    try {
        paymentApi.pay(orderId);
        return;
    } catch (Exception e) {
        Thread.sleep(1000);
    }
}
读起来没有问题,跑起来也能跑。但这十行里藏着四件事:
第一,sleep 占住的是 Tomcat 的业务线程。 每次卡一秒,三次就是三秒。下游一慢,线程池在几十秒内见底,然后整个服务开始拒绝它本来完全能处理的请求。一次下游抖动,被放大成一次全站雪崩。
第二,进程退出,重试的上下文一起消失。 内存里那个 i 不会留下来,正在等的这条请求也不会。
第三,集群三个实例会同时重试。 同一笔退款被扣三次,然后你在财务对账时第一次见到它们。
第四,间隔固定一秒。 下游正在限流,你恰好在它最痛的时候,用最规律的节奏反复敲门。
Spring Retry 解决了第一个——它可以配 backoff,可以不那么粗暴。但它没有解决后面三个,因为它的世界边界是单个 JVM。而分布式系统里,「失败」这个词的定义,本身就已经跨出了 JVM。
所以我对这件事的判断是:
重试真正的难点,从来不是「再来一次」,而是「失败了之后,谁还记得这件事」。
一次重试是动作。一段可恢复的重试,是状态。这两者的距离,比大多数人以为的远。
二、中心化重试平台,在容器时代撞上了一堵墙
先公道地说,中心化重试平台是一类值得尊重的设计:任务集中存储,到点由服务端反向 HTTP 回调业务接口,谁在重试、重了几次、卡在哪一步,全在一个后台里看得清清楚楚。
它有一个前提条件,而这个条件很少被写进架构文档里:
服务端必须能访问业务服务。
在物理机和固定 IP 的年代,这几乎是免费的。到了容器时代,它开始变贵:Pod 重建之后 IP 换了;跨 VPC 之后路由不归你管;至于内网安全隔离的环境,这条反向链路根本不存在。
这里有一件事我想说透,因为它比技术选型更根本:
网络拓扑,本质上就是权限拓扑。 「谁能反向访问谁」,在企业内网里从来不只是配置文件里的一行,它是安全评审、是防火墙策略、是审批流。一个要求「调度中心必须能打到你每一个业务容器」的组件,在很多环境里连上线评审都过不了,技术上再优雅也没用。
ElecCloud 的答案是把这个控制关系再反转一次:
服务端退化成只负责存取的数据节点,调度权下放给客户端 SDK。SDK 把延时任务投进 Redis ZSET 或 RabbitMQ 的延时队列,到期后自己取、自己反射执行。整条链路的方向变成「业务 → 平台」,只需要单向连通。
三条实线是必须的,那条红色虚线是被主动砍掉的。砍掉它省下的不是带宽,是一整轮安全评审。
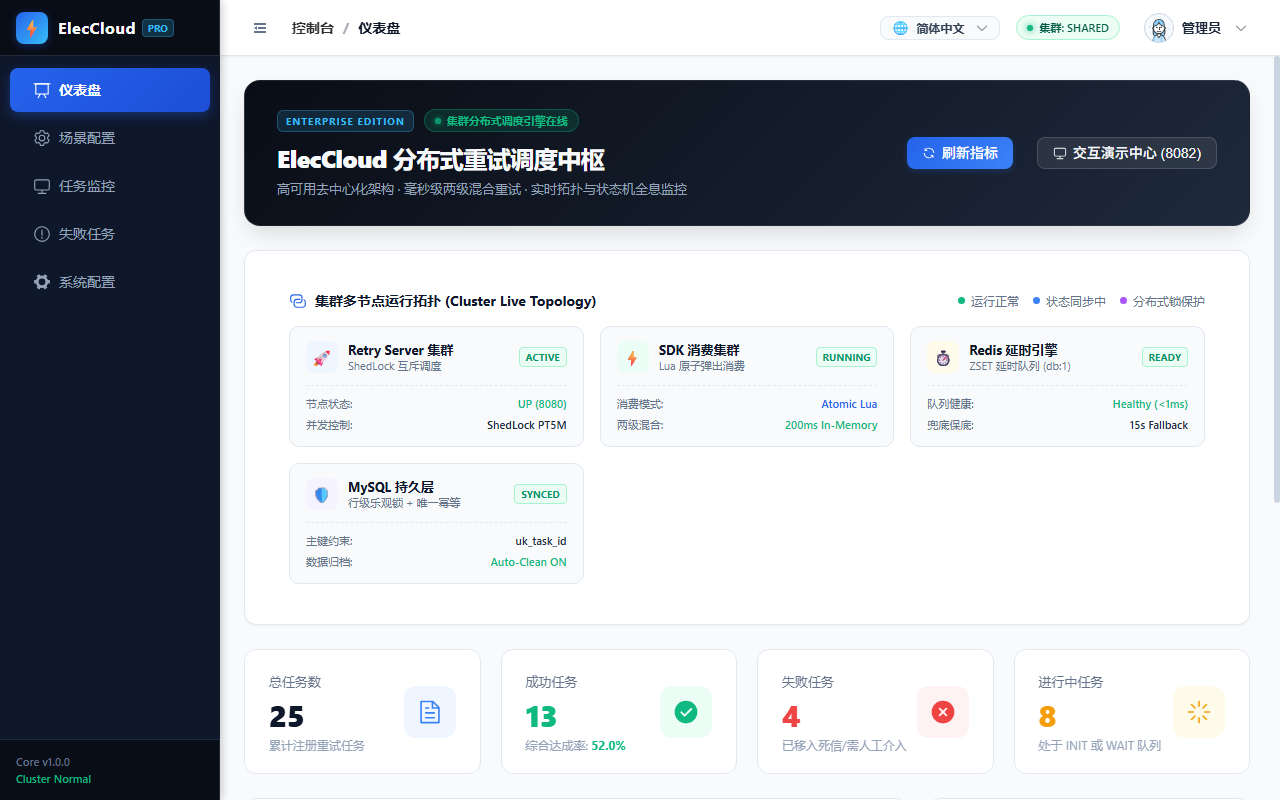
控制台首屏,把 Retry Server、SDK 消费集群、Redis 延时引擎、MySQL 持久层四段链路的健康状态并排摊开。判断一个分布式组件好不好用,先看它的首屏敢不敢把拓扑直接给你。
代价我不打算藏:
- SDK 是代码,跟着业务版本走。 升级意味着发版,不像纯服务端方案那样改个配置就生效。
- 服务端失去了「精确控制某一次执行」的能力。 它只能观测和干预状态,不能替业务执行。
- 每个服务要维护自己的队列名做隔离。 命名这件事一旦随意,日后排查会很难受。
这三条是真实的成本。一个只有优点没有代价的架构描述,通常意味着作者还没上线过。
三、两级时间:快与慢必须分开算
如果只允许我保留 ElecCloud 的一个设计点,我会保留这个。
先看一个我认为被严重低估的工程常识:
不要让工具的时间粒度,粗于问题的时间粒度。
一次 50 毫秒的连接重置,和一次持续四十分钟的支付网关故障,是两件性质完全不同的事。前者是网络在打个喷嚏,后者是下游进了 ICU。用同一套机制去处理,结果必然是两头都不对:为一次喷嚏写一条数据库记录、投一条 MQ 消息,是荒谬的写放大;而面对 ICU 病人,靠本地 Thread.sleep 硬扛,是拿线程池陪葬。
所以 ElecCloud 把时间分成两级:
@RetryableTask(
    sceneType = 1001,
    idempotentKey = "#orderId",
    localRetryTimes = 2,      // 第 1 级:本地快重试两次
    localIntervalMs = 200     // 间隔 200 毫秒
)
public void processPayment(String orderId) {
    paymentApi.pay(orderId);
}
第一级:本地、200 毫秒、两次。零 DB、零 Redis、零 MQ。 绝大多数瞬态抖动在这一层就地消失,方法正常返回业务结果,调用方甚至不知道刚才发生过什么。
第二级:本地耗尽之后自动升级。 任务入库、投进延时队列、按指数退避重新排期,同时把当前线程还给容器。
同一根时间轴上的两级:0 到 400 毫秒属于本地,之后交给持久化层。分界线不是人为设定的阈值,而是「值不值得为它写一次盘」这个成本判断。
这个结构在生活里有个精准的对应:门诊与住院。
鼻血流一下,门诊处理完就回家,不需要办住院手续、不需要建病历档案。真正需要的是持续观察和排程治疗的,才建档、才排床位、才进入那套有记录可查的流程。你不会为一次鼻血走完住院流程,也不该让重症患者在门诊长椅上躺三天。
大部分重试系统的问题,就在于它只有其中一套流程。
四、预提交:把最危险的那一毫秒提前
最阴的失败不是抛异常。抛异常是好事,它至少给了你一次写日志、改状态的机会。
最阴的是进程根本来不及留下遗言。OOM Killer 挑中了你,容器被驱逐,机器直接掉电——业务侧已经把请求发出去了,本地一个字都没写。重启之后,没有人知道那笔请求存在过。
常规做法是「事后补偿」:失败了再记一笔,然后补偿。但这套逻辑偷偷依赖了一个假设——进程能活到把失败写下来。线上环境里,这个假设经常不成立。
ElecCloud 换了个方向,叫 PRE_SUBMIT:在业务方法执行之前,先把一条 INIT 状态的记录落进数据库。
- 执行成功 → 状态改为
SUCCESS - 执行中进程死了 → 那条
INIT还躺在库里,扫描任务会把它捡回来
差别就一句话:事后补偿假设进程会活,预提交假设进程随时会死。后者才是生产的真相。
代价同样明确——每次执行多一次写。所以它不该是全局默认,只该用在「重复执行会造成真实损失」的方法上:退款、扣款、发券、扣库存。同步缓存这类天然幂等的操作,走零 Hook 的普通模式就够了。
工程判断力,很多时候不体现在你加了什么,而体现在你知道哪些地方不该加。
五、真正的敌人不是失败,是重复
分布式系统里让人半夜惊醒的,从来不是「这次失败了」,而是「这次到底成功了几次」。
同一笔订单被两个实例同时捡起来执行,是这类系统最经典的翻车方式。ElecCloud 在这里设了两道闸:
第一道,唯一索引。 (scene_type, idempotent_key) 上的唯一约束,从数据库层面直接拒绝第二条记录进入。这不是应用层的 if 判断,是存储层的物理拒绝,绕不过去。
第二道,CAS 抢占。
UPDATE retry_task
SET status = 'EXECUTING', ...
WHERE id = ? AND status IN ('INIT', 'WAIT')
把状态从 INIT 或 WAIT 抢到 EXECUTING,改到行的那一个实例才算抢到。没改到就是没抢到,干净退出,不吵不闹。这是一种无锁的分布式互斥——没有分布式锁的开销,也没有锁服务挂掉之后的连环事故。
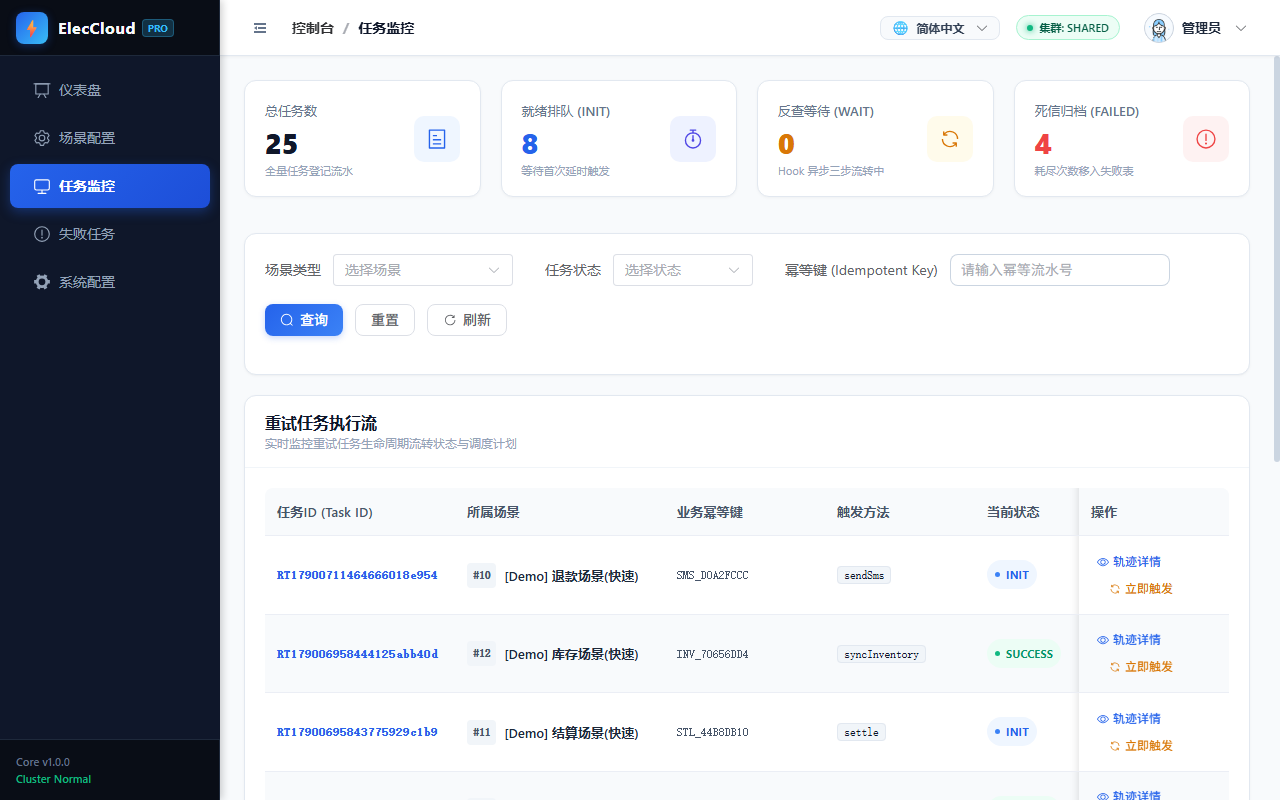
任务监控页。RT1790071146466018e954 这类任务号、场景 #10 到 #12、业务幂等键、当前状态,一行一条,全部可追。分布式系统里「可观测」不是锦上添花,它是排查时唯一的抓手。
再往上,是业务语义层的防重——三阶段 Hook:
checkStatus → doQuery → doCallback
先去问下游「这件事到底成没成」,再决定要不要重做,最后做本地回调落账。很多所谓的重试事故,根因不是重试本身,而是不知道上一次到底成功了没有。把「先问再动」写成流程,比把重试次数从 3 调到 5 有用得多。
底层还有三层兜底:MQ 消息丢了 → 数据库扫描补;EXECUTING 状态僵死 → 超时自愈;扫描也失效 → 由分布式锁保证同一个扫描任务不被多节点重复执行。
这套设计不好看,也不聪明。但它每一层都对应一种真实发生过的故障模式。
六、四个退避策略,和一份「不做什么」的清单
退避策略给了四种:CUSTOM、FIXED、LINEAR、EXPONENTIAL。
大多数场景选指数退避,但有个细节必须配:jitter,抖动。如果不加随机扰动,一批在同一秒失败的任务,会在同一秒一起去重试,然后一起失败,一起再重试——这就是惊群。它看起来像「下游扛不住」,实际上是你的重试系统自己制造了一次小型 DDoS。
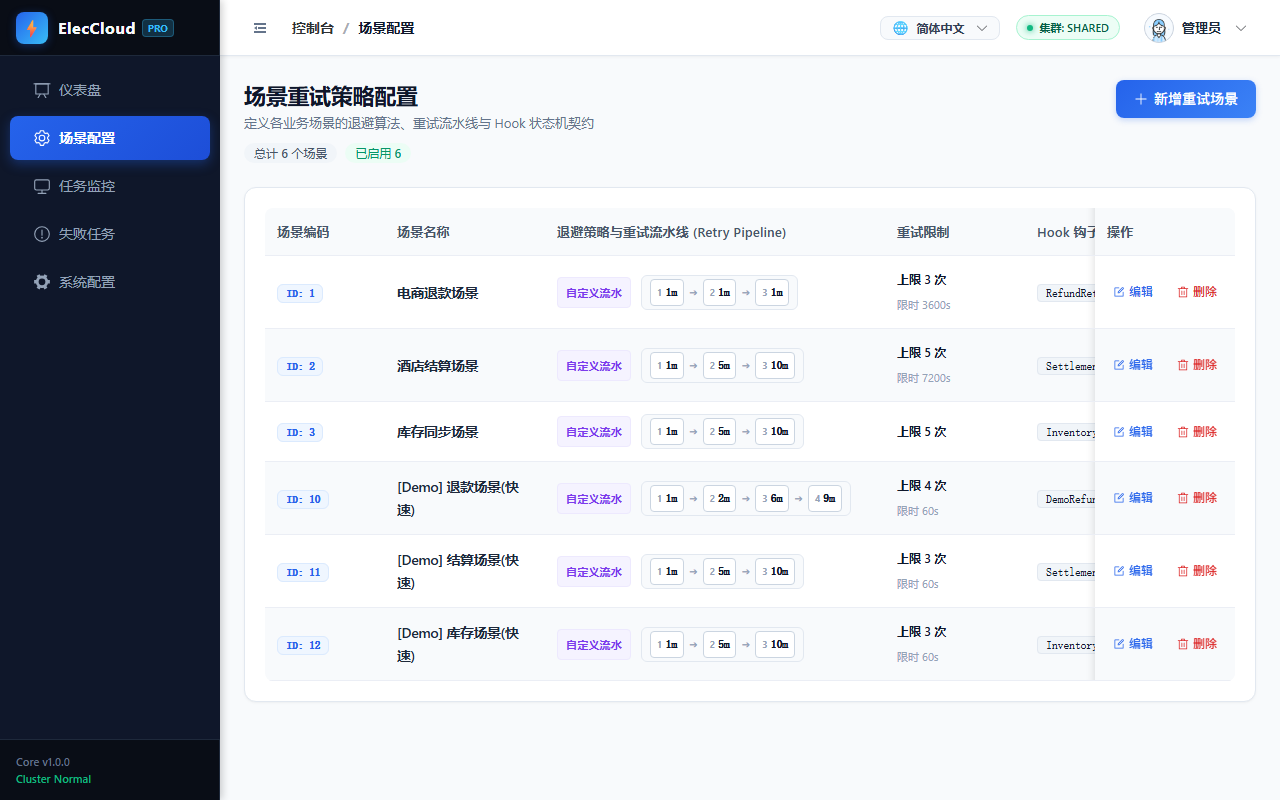
场景配置页。一个 sceneType 对应一套退避策略和重试上限,业务侧只认这个编号,不用关心底层是 Redis 还是 RabbitMQ。
同样重要的是它不做什么,这份清单我想写得比功能列表更认真:
- 不做 cron 批处理调度。 那是 XXL-JOB、ElasticJob 的地盘,它们做得很好,没必要抢。为每一次方法级的偶发失败去配一个 JobHandler,运维成本高得离谱。
- 不做大而全。 没有 DAG 依赖,没有分片,没有工作流编排。一旦开始做这些,它就会变成另一个需要专职运维的中间件。
- Standalone 模式有真实代价。 纯 SDK + 本地库,不需要任何外部服务,五分钟能跑起来;但集群多节点之间的协同也就没了,它只适合单体或小规模场景。
- RabbitMQ 通道依赖延时插件。 选它之前,先确认运维愿意装。
架构上的克制不是道德品质,是维护成本的计算结果。一个开源项目最怕的不是功能少,是功能多到没人敢升级。
七、都江堰:水不会消失,只能被引导
公元前 256 年,李冰在岷江上修都江堰。
他没有筑一道坝把水拦住。他用鱼嘴把江水分成内江和外江,用飞沙堰在汛期把多余的洪水和泥沙甩回外江,用宝瓶口把真正需要的那部分水引进成都平原。三个工程,一个思路:
水不会消失,只能被引导。
这套东西用了两千两百年,今天还在灌溉一千万亩农田。它治的从来不是「水」,治的是「不可预测」这件事本身。你没办法让岷江不涨水,你只能让它在涨水的时候,有一个确定的方向、一个明确的出口、一条算得清的边界。
重试是同一件事。
下游会超时,网络会抖,进程会死,容器会被驱逐。这些不会因为你代码写得更认真就消失,也不会因为你在评审会上强调「这个接口很重要」而手下留情。工程能做且唯一能做的,是让每一次失败都有方向、有边界、有归宿。
项目叫电子云,说的也是这个。
量子力学里,单个电子的位置测不准——就像分布式网络里那一次突发的抖动、那一次说不清原因的超时。但无数电子在核外形成的概率云,给了原子一个极其稳定的物理边界,让原子核在宇宙射线里活了下来。
微观上不可测,宏观上必确定。这不是一句文案,这是分布式系统唯一能站得住的承诺。
八、回到那笔退款
它最终到达了。
不是因为这套系统从不出错——它每天都出错。而是因为出错之后,系统还知道该去哪里把它找回来。
如果只留三句话:
第一,重试不是「再来一次」,是「记住这件事」。 动作会随进程消失,状态不会。
第二,架构的第一性问题往往不是性能,是连通性。 谁能访问谁,决定了什么方案有资格存在。很多方案的死因,在写第一行代码之前就已经注定了。
第三,最好的兜底不是更强的重试,是更早的记录。 把状态提前写下去,比事后补一百行补偿逻辑都管用。
源码在这里,Apache-2.0,欢迎读、欢迎提 Issue、欢迎拍砖:
https://github.com/chaoking320/eleccloud
<dependency>
    <groupId>io.github.chaoking320</groupId>
    <artifactId>retry-client-sdk</artifactId>
    <version>1.0.1</version>
</dependency>
一行注解就能接进去。如果它帮到了你,点个 Star 是最省力的感谢。
善意·爱 · ShanYi·AI
永远对世界保持善意与好奇。