听见脉搏,而不惊动它:LightPulse APM 极轻量监控系统设计
一、1816 年,一个不好意思的医生
1816 年,巴黎。雷内克(René Laennec)遇到一位心脏有问题的年轻女病人。按当时的常规,他应该把耳朵直接贴到她的胸口去听。
他觉得不妥。于是他卷起一张纸,做成一个圆筒,一端贴在她胸前,一端贴在自己耳上。
他听见了心跳,而且比贴耳听得更清楚。
那个纸筒后来变成了木质听诊器,成为医学史上最成功的器械之一。但它的第一动机不是「听得更响」,而是在必须听清的前提下,保持一定的距离。
我一直觉得这是监控系统最好的隐喻。
运维里最常见的冲动是「看得更多」:更多埋点、更多指标、更多大屏。但看得越多,被看的那台机器就越慢;等监控本身成了故障源,你就再也分不清——是系统真的病了,还是探针太耗资源,把系统给憋死了。
所以这套系统从第一行代码起,就在回答同一个问题:能不能退开半步,仍然听得清?
二、链路的形状,是被约束逼出来的
先说我遇到的三条硬约束。它们不是「最佳实践」,是评审结论:
其一,不能为监控开入站端口。 内网里每开一个端口都要过安全评审。一个「运维辅助工具」想开 9100 或 8080,通常的回复是:请使用现有通道,新开一个端口就意味着风险增加一分。
其二,不能装系统级采集插件。 node_exporter、telegraf 这类东西要落二进制、要 root、要跟 OS 版本对齐。几十台机器 OS 版本参差的时候,这件事的长期维护成本比它带来的收益还高。
其三,不能连公网。 没有 SaaS,没有云托管,没有在线告警聚合。一切自建。
三条约束叠在一起,链路就只剩一种形状了:
FIG. 01 · 采集、上报、落库、判定、通知。整条链路上只有一次「出门」——从被监控主机发出,永远不会有人从外面走进来。
Agent 只做三件事:采集、缓冲、POST。它在被监控的机器上不监听任何端口——我把整个 monitor-agent 模块翻了一遍,ServerSocket 出现零次,@RestController 出现零次。它只会往外发请求,也只会往外拿配置:每 60 秒拉一次(configPollIntervalMs = 60000),所以你在控制台上改了探针,一分钟内生效,业务不用重启。
单向连通这件事,在容器和防火墙的世界里从来不是性能问题,是能不能连上的问题。任何要求「服务端反向访问客户端」的监控设计,在真实内网里都会先死在权限评审上——这一条,我在另一个项目里付过学费。
三、free 骗过所有人
采集器是纯 Java 写的,不引任何第三方库。CPU 和内存走 JDK 自带的 com.sun.management.OperatingSystemMXBean。
但内存这一项,我一开始写错了。
OSBean 给的是 getFreeMemorySize()——空闲内存。用 1 - free/total 算使用率,在 Linux 上会持续偏高十到二十个百分点,因为它把 buff/cache 算成了已用。而那些缓存是内核随时可以回收的,机器实际上一点也不缺内存。
后果不是「数字不好看」,而是假告警:一台实际 45% 的健康机器被算成 68%,配上 90% 的阈值,某天业务真跑起来,一晚上给你发八条「内存将满」。
所以加了一小段 /proc/meminfo 解析:
private static long getLinuxMemAvailable() {
    File meminfo = new File("/proc/meminfo");
    if (meminfo.exists() && meminfo.canRead()) {
        // 找到 MemAvailable 行, 单位 KB, 转字节
        if (line.startsWith("MemAvailable:")) {
            return Long.parseLong(parts[1]) * 1024L;
        }
    }
    return -1L;   // 读不到则回退 OSBean
}
优先用 MemAvailable,读不到才退回 OSBean。这样控制台上那个数字,和你在机器上敲 free -m 看到的 available 是对得上的。
一个跟现场对不上的监控数字,比没有数字更危险——因为它会让你开始怀疑自己的判断。
磁盘是另一头的问题。大多数巡检脚本只看 /,而生产机器上最先满的几乎从来不是 /,是 /data、是 /opt、是容器层的 overlay。
所以采集器干了一件笨事:遍历所有 FileStore,把 tmpfs/devtmpfs/proc/sysfs/cgroup/overlay 这些噪声一律过滤,剩下的每个挂载点单独上报。
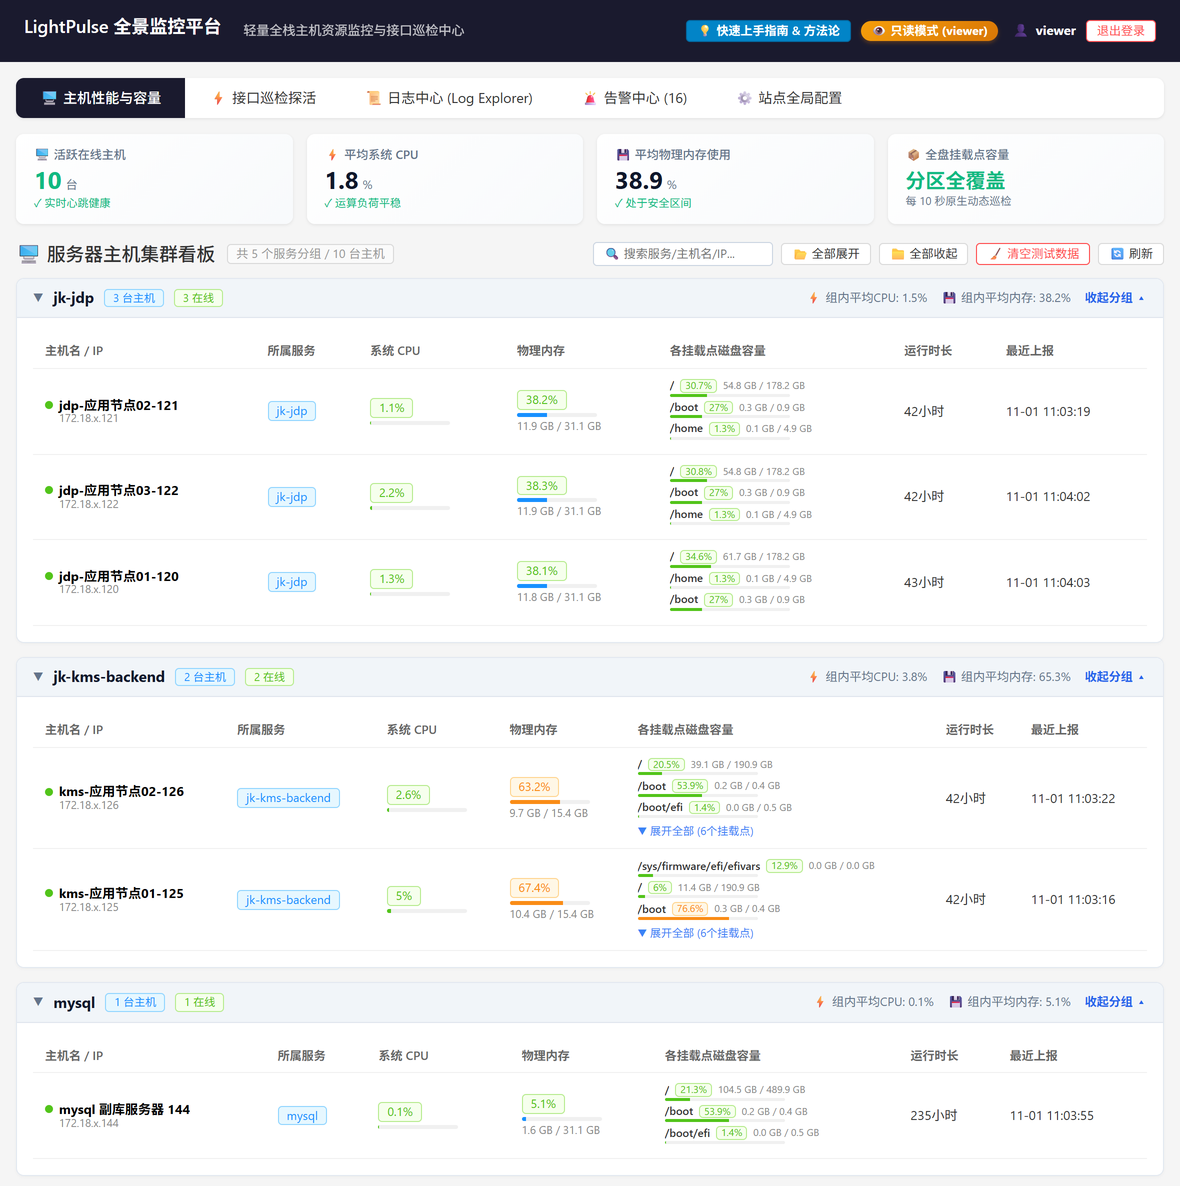
FIG. 02 · 主机性能与容量总览。顶部四个数是全站概览:10 台在线、平均 CPU 1.8%、平均内存 38.9%、分区全覆盖。下面一台机器一行,右侧一排小胶囊是它的每个挂载点——jk-jdp 那三台几乎一模一样(/data 30.7%、/boot 27%、/home 1.3%);kms-应用节点01-125 的 /boot 已经 76.6%,而 mysql 副库 的 / 才 21.3%。分组标题栏上还有组内平均 CPU 与内存(jk-kms-backend 65.3%),一眼能看出哪一组整体偏热。图中共 5 个服务分组、10 台主机,这里截取了前三组。
「分区全覆盖」是这套系统最早被同事认可的一点。因为「/data 已经 90% 了」这句话,只有在你看得见 /data 的时候,才说得出口。
四、巡检真正的敌人,是身份会过期
主机指标是好做的。真正难的是业务接口。
不是「这个 URL 通不通」——那种巡检,一个 curl 加一条 cron 就够了。难的是:这些接口要鉴权。
拿线上一个真实对象举例。KMS 的对话接口要先拿 accessToken:
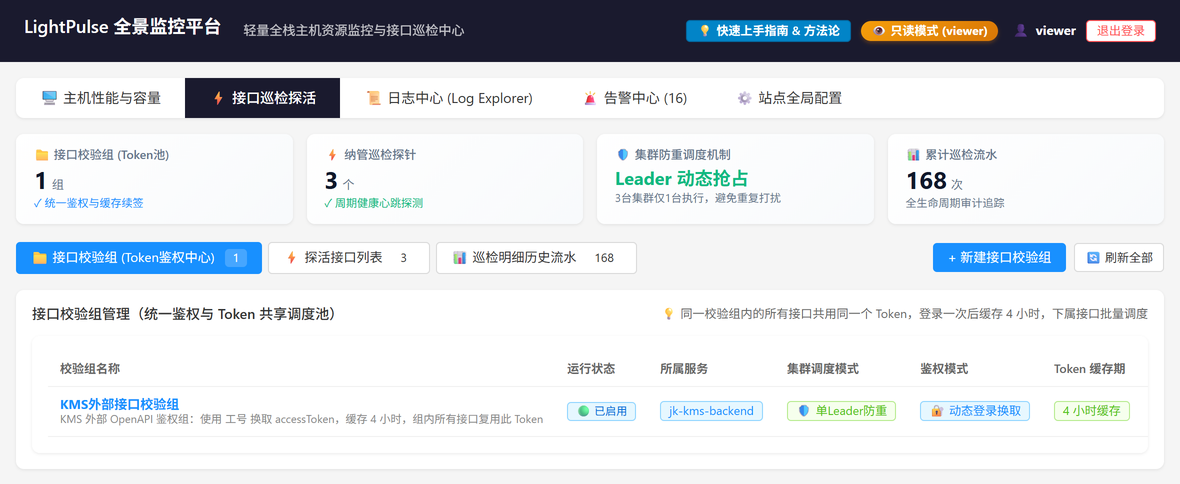
FIG. 03 · 校验组是 Token 的容器。组内说明写得很直白:使用工号换取 accessToken,缓存 4 小时,组内所有接口复用此 Token。「集群调度模式 · Leader 防重」和「鉴权模式 · 动态登录换取」是第六节与本节的主角,最右一列则是这个 Token 的实际保鲜期。
这就不是一个请求了,而是一个状态机:
缓存命中且未进入缓冲期 → 直接复用,不发登录请求。
即将过期或尚未持有 → 调登录接口换新的。
请求返回 401 → 判定 Token 提前失效,强制刷新,只重试一次。
刷新失败但旧 Token 未彻底过期 → 降级用旧的,把失败写进日志,下一轮再试。
最后两条是关键。
「组内共用」防的是登录风暴:三个探针如果各登一次,你巡检自己就在打登录接口。
「刷新失败降级」防的是把鉴权抖动放大成全面告红:真实内网里登录服务偶发 5xx 是常态,此刻正确的动作是拿旧 Token 撑过去,而不是立刻宣布业务挂了。
代码里那个双重检查锁写得很老实,没有任何花活:
boolean needRefresh = forceRefresh || cached == null
        || now >= (cached.getExpireAtMs() - bufferMs);

if (needRefresh) {
    synchronized (tokenCache) {          // 只锁刷新, 不锁读
        cached = tokenCache.get(cacheKey);
        if (forceRefresh || cached == null
                || now >= (cached.getExpireAtMs() - bufferMs)) {
            tokenCache.put(cacheKey, acquireNewToken(config));
        }
    }
}
缓存的 key 是「登录地址 | Token 路径」的哈希;同一个 key 只允许一个线程去登录,其余线程在锁外拿着旧值继续跑。这是我能找到的、对业务影响最小的写法。
五、接上生产之后,最先让我改观的是耗时
这套东西跑起来以后,第一件让我改变判断的事,不是告警,是耗时。
同一个接口、同一台机器、同一个 Token,巡检流水长这样:
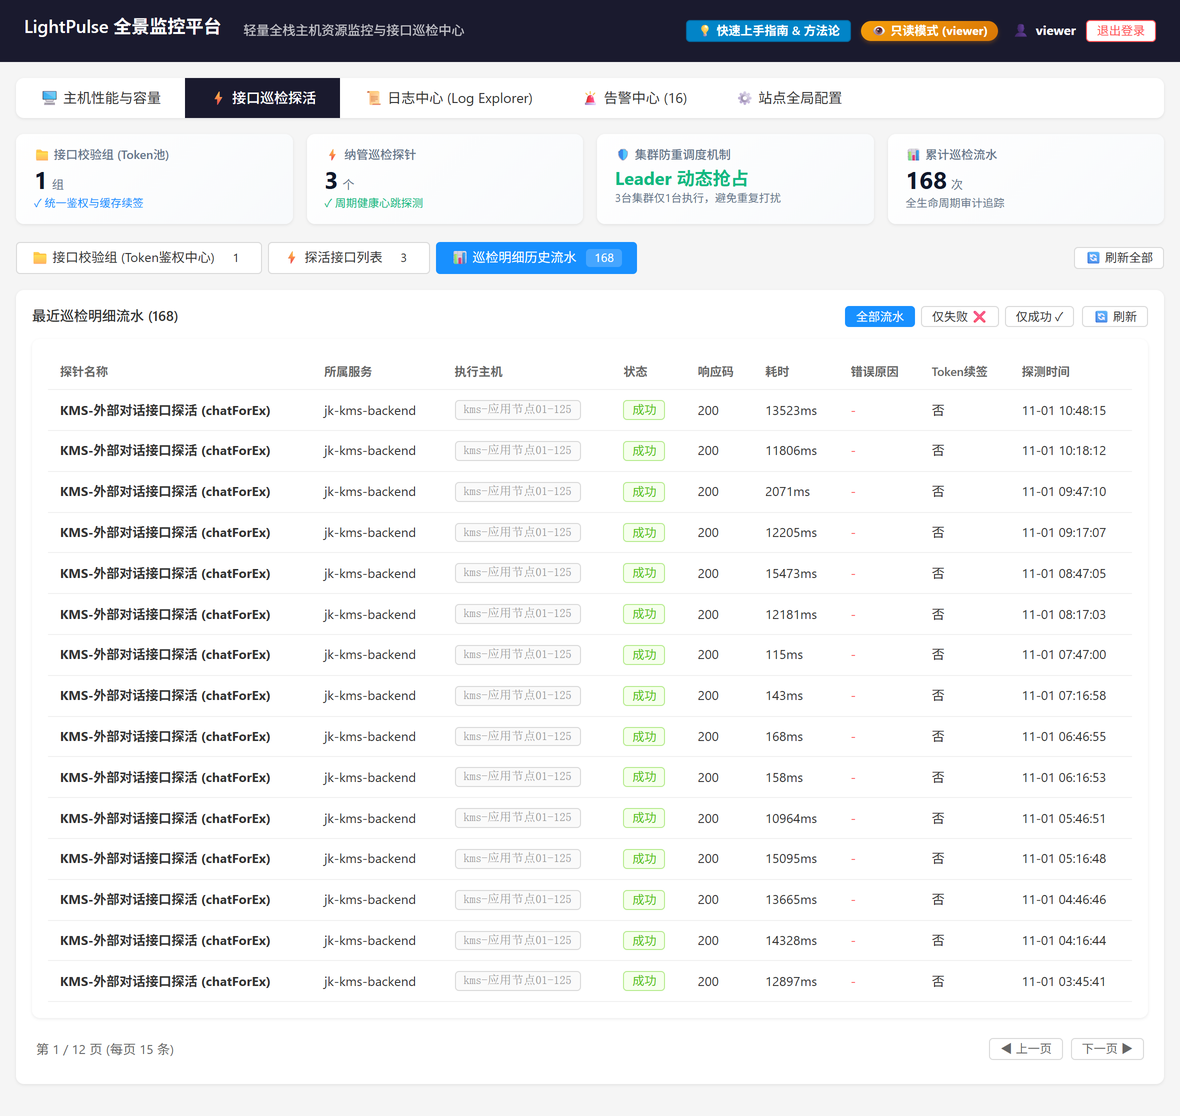
FIG. 04 · 13523ms、11806ms、2071ms、12205ms、15473ms、12181ms、115ms、143ms、168ms、158ms、10964ms、15095ms…… 一共 168 条流水,12 页(每页 15 条)。「状态」一栏全绿,「错误原因」一栏全是「-」——而「耗时」在两个量级之间来回跳。「执行主机」从头到尾是同一台,这是第六节要说的集群选主。
从上往下读两遍,会看到两个量级交替出现。更值得看的是时间戳:09:47:10 → 09:17:07 → 08:47:05 → 08:17:03 → 07:47:00——严格每 30 分钟一次,这就是探针的执行周期。而耗时在 07:47 到 06:16 这一段连续四次掉到 115ms、143ms、168ms、158ms,前后则全是 12 到 15 秒。
如果巡检只记「成功/失败」,这一百多条流水会全部是绿的——它们确实都返回了 200。
一个在 115ms 和 15 秒之间摇摆的接口,算故障还是算正常,完全取决于你有没有把耗时记下来。所以我把这个字段命名为「耗时」而不是「响应时间」:响应时间听起来像 SLA 指标,耗时只是一个事实。
探针本身的参数也在这本账上:三个探针各自独立,方法、超时、执行周期、期望状态码、断言关键词都能单独设。线上这个 KMS 外部接口探针,超时 60 秒、周期 1800 秒、期望 200。
这组数字后面是两个不体面但真实的选择:超时给到 60 秒,因为接口本身最多要 15 秒,卡窄了就是自己制造误报;周期放到 30 分钟,因为它叫「探活」,不叫「压测」。
一个每十秒去打一次业务接口的巡检工具,自己就是被巡检对象。
六、集群里,到底派谁去打这一枪
同一个服务通常跑三台。三台机器上各有一个 Agent,各自都拉到了同一份探针列表——那么问题来了:打三次,还是打一次?
打三次的后果很具体:三次重复登录、三条重复告警、监控接收人被 @ 三遍。
标准答案有两个:Redis 分布式锁,或者 ZooKeeper 选主。两个我都想过,然后都放弃了——为了一分钟一次的选主,引入一个必须高可用的中间件,是本末倒置。
最后用的是最笨的办法:
从在线表里挑出这个应用集群中
hostName字典序最小的那台,它就是 Leader。分发探针时,非 Leader 的节点什么都拿不到。
没有锁,没有租约,没有周期续约。Leader 挂了怎么办?它下一轮心跳超时,从在线表里消失,字典序第二小的机器自动变成最小。抢占时间等于失联判定时间,线上配的是 600 秒。
代价说清楚:最多 10 分钟的巡检真空。
收益也说清楚:零个新组件,零个新故障点。对一个「必须比业务活得久」的监控系统来说,这笔买卖划算。
选主这件事上还有一个我必须交代的细节——它解决的是误报,不是选举。服务重启之后,旧实例的那条心跳记录还没过期,表里会同时出现「旧的离线中」和「新的在线」两条。如果不管,每次发布都会收到一条「服务宕机」告警。所以判定失联时先看同主机下有没有在线的新实例:有,就认定旧记录是幽灵,直接清掉,不发告警。
// 自愈防误报: 同主机已有 online 的新实例 → 旧记录是重启遗留的幽灵, 静默清理
var activeSibling = appRepo.selectList(
        new LambdaQueryWrapper<ApmApplication>()
        .eq(ApmApplication::getHostName, app.getHostName())
        .eq(ApmApplication::getStatus, "online")
        .ne(ApmApplication::getInstanceId, app.getInstanceId()));
if (activeSibling != null && !activeSibling.isEmpty()) {
    appRepo.deleteById(app.getId());
    continue;   // 幽灵记录, 直接清掉, 不发告警
}
这段代码不长,但它是被发布日的告警轰炸教育出来的。监控系统真正的对手从来不是「没抓到」,是「抓错了」。
七、让告警学会闭嘴
一套监控第二次被人关掉,通常不是因为不准,是因为太吵。
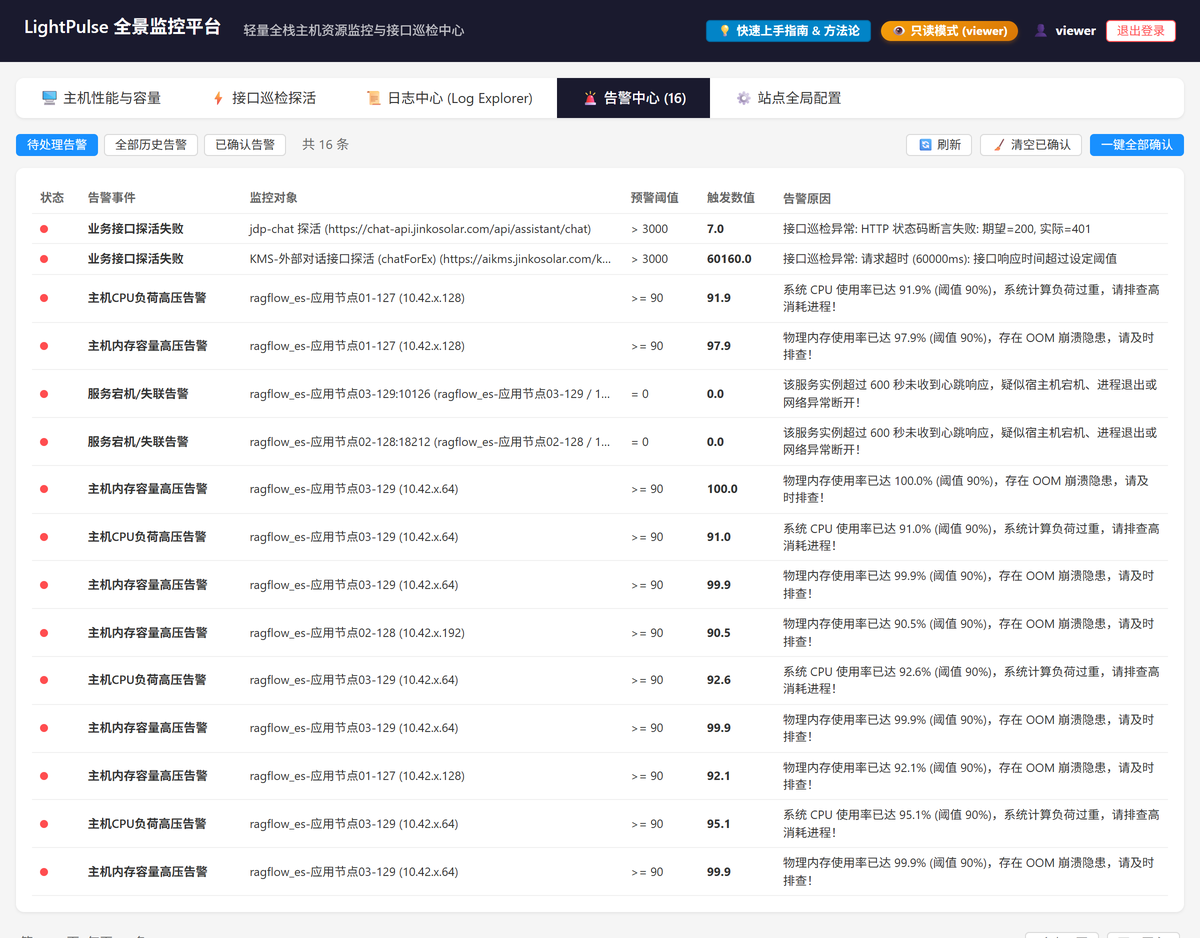
FIG. 05 · 告警中心,16 条待处理。最上面两条是业务接口探活失败,往下几乎全是 ragflow_es 那三台集群在 CPU/内存上反复越线,中间夹着两条服务失联(超过 600 秒没收到心跳)。同一台 03-129 在「内存高压」上连报四次——18:25、18:56、19:26 都是 99.9%,19:56 才冲到 100.0%。
每一行右侧还有三列:预警阈值、触发数值、告警原因。举最上面两条——
jdp-chat 那条,阈值 > 3000,触发值只有 7.0:耗时完全正常,但断言失败,「期望=200,实际=401」。一个 401,就是第四节讲的那件事真的发生了。另一条 KMS 外部对话接口,触发值 60160.0:探针老老实实等满 60 秒才放弃,原因写着「请求超时 (60000ms)」。
一个是门锁被换了,一个是门后的人不吭声。两种病,两种治法——而如果只记「失败」,这两条在列表里长得一模一样。
没有「疑似」,没有「可能」,只有一条可以被复核的判定。
收敛靠一个静默窗口。key 是 告警类型:应用:目标,默认 30 分钟内同一个 key 只放行一次,窗口内的告警既不入库,也不推送。
我特意选了「不入库」这个更激进的做法。更常见的实现是「入库但不推送」——看起来信息更全,实际上只是把噪音从群聊挪进了告警列表。而告警列表一旦变成流水账,就没人看了。
一个没人看的告警列表,和一个没有告警,在结果上没有区别。
代价也很清楚:那四次的间隔是 30 分 28 秒、30 分 13 秒、30 分 28 秒——全都在 30 分钟窗口刚过期的那一刻,所以每一次都放行了;反过来,如果它在 19:00 到 19:25 之间又冲一次 99.9%,你一条也收不到。这是主动接受的风险——从 99.9 到 100 这个变化,不改变你要做的动作。
通知渠道统一走群机器人(钉钉/企业微信/飞书),自动识别 URL 拼对应的 markdown 格式,支持加签。这一层没什么技术含量,但它决定了前面所有工作最后有没有人看见。
八、顺手长出来的日志中心
这套系统本来是「指标 + 探针」,日志是后来加的。
理由很功利:指标告诉你「这台机器 CPU 90%」,但不会告诉你为什么。而人一旦开始查原因,第一件事永远是上机器 tail -f。
做过一次就知道,在多台机器、多个容器里定位一条报错有多麻烦:先知道是哪个节点,再知道容器名,再 docker logs,再往回翻几百行。等你翻到的时候,截图已经过期了。
所以做了一个最朴素的版本:Agent 按配置路径 tail 日志文件,逐行上报;服务端按「应用 + 主机 + 日志文件」建索引;前端给你一个关键词框和一个 TraceID 框。
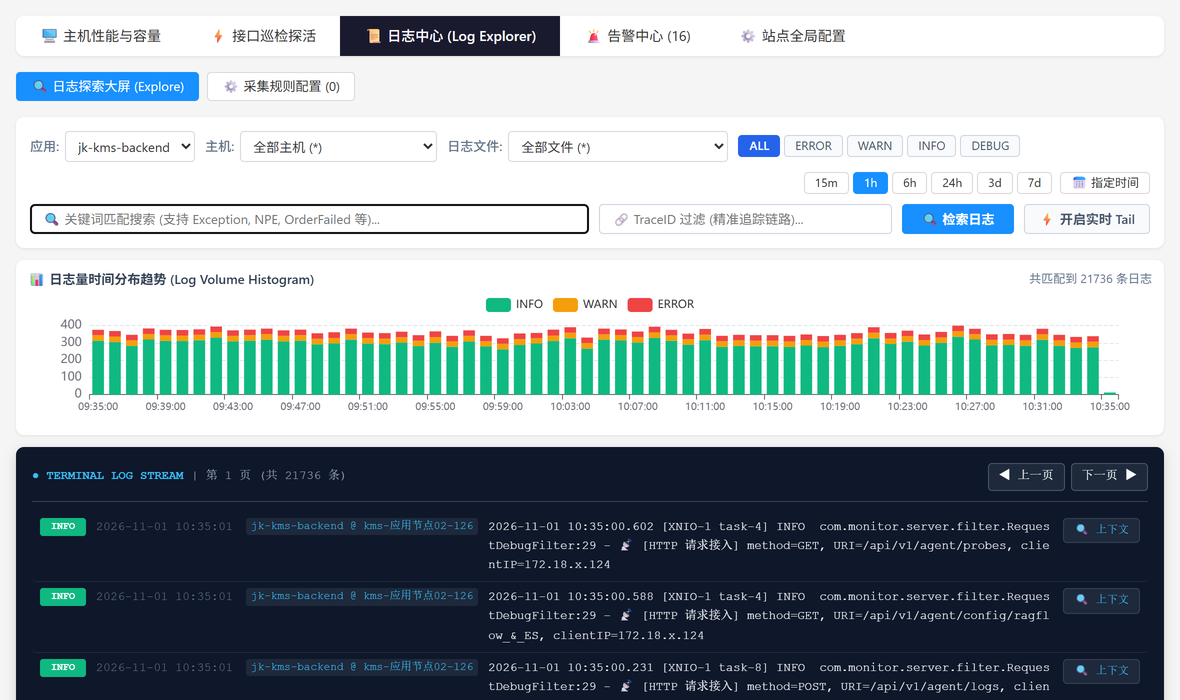
FIG. 06 · 应用选 jk-kms-backend、时间窗 1 小时,共 21736 条。上方直方图三色叠在一起:绿是 INFO,橙是 WARN,红是 ERROR。下方是跨主机的实时日志流,每条都带应用、主机、线程、logger 和客户端 IP。
这张图真正的用法不是「看日志」,是「看形状」:柱子上什么时候开始冒橙色,哪一段红色特别密,那才是需要点进去的时刻。先看见不对劲,再决定要不要看内容——这比直接扔给你两万行日志有用得多。
九、存储:要能长大,也要能忘掉
这套东西被装进过三种完全不同的环境:我自己的笔记本、一台 4C8G 的测试机、以及生产的三台集群。它们对存储的要求彼此冲突。
所以存储做了四档,在控制台上直接切,不用改配置文件重启:
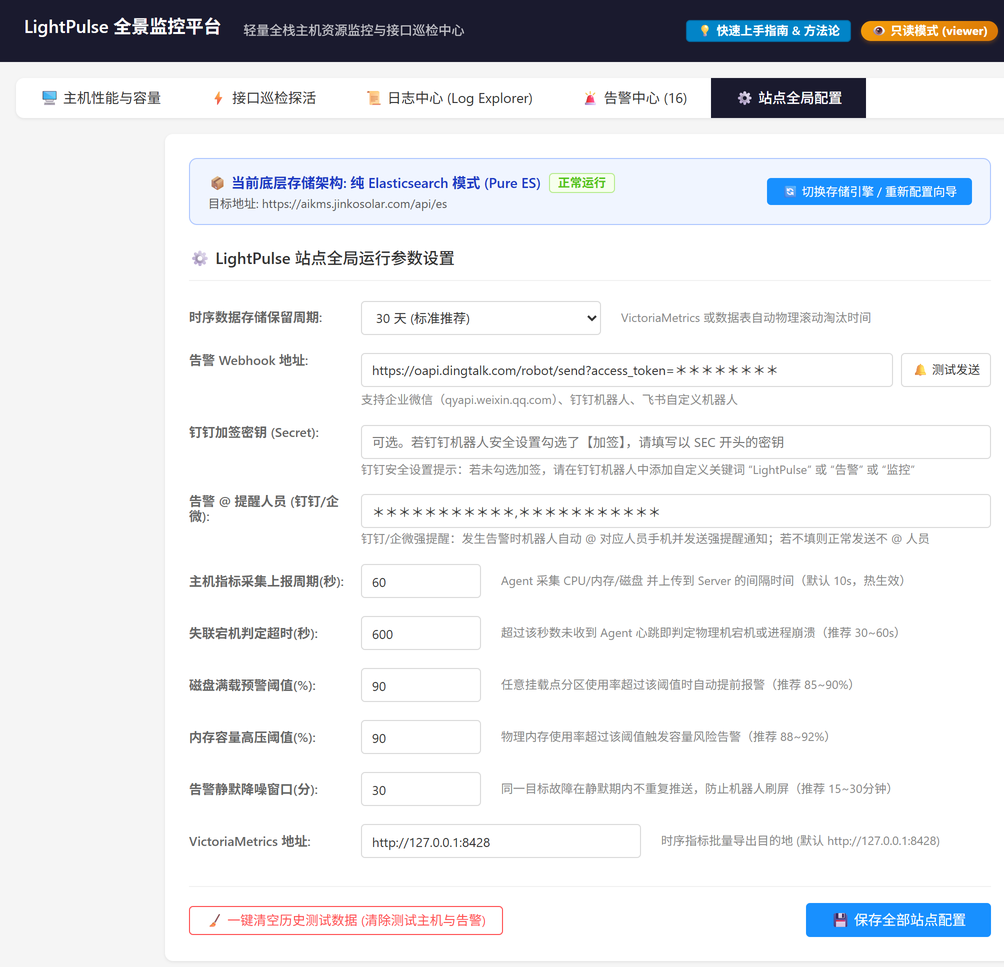
FIG. 07 · 站点全局配置。顶部是当前存储档位(纯 Elasticsearch),下面是全部运行参数:采集 60 秒、失联判定 600 秒、磁盘与内存阈值各 90%、静默窗口 30 分钟、保留 30 天。这些不是文档里的示例值,是线上正在生效的值。
| 档位 | 用什么 | 适合谁 |
|---|---|---|
| 嵌入式 | H2 文件库,零安装 | 单机试用、演示、给小团队看效果 |
| MySQL | 一张表 + 一个索引 | 已有 8.0 实例,量不大,想跟业务库放一起 |
| 纯 ES | Elasticsearch,按天滚动索引 | 主机多、日志多、要按时间范围翻 |
| 混合 | MySQL 管配置,ES 管时序 | 生产:配置要事务,指标要吞吐 |
线上现在跑纯 ES。指标和探针流水分别落在按天滚动的索引里:metrics-2026.11.01、probes-2026.11.01。
按天滚动不是为了时髦,是为了让删除变便宜:
// 每天 03:30
if (storageEngineService.isEsActive()) {
    // 整索引 DROP, 毫秒级
    esStorageService.cleanExpiredIndices(config, retentionDays);
}
// 非纯 ES 模式下才去 DB 里 DELETE WHERE created_at < 阈值
保留 30 天。每天凌晨 03:30,把 30 天前的整个索引丢掉。不用 DELETE WHERE,不用分批,不用关心 deleted docs 什么时候真正回收——索引级的 DROP,是这个规模下唯一不疼的清理方式。
60 秒的采集周期也不是随手定的:10 台机器 × 1440 分钟 ≈ 一天 1.4 万行,一个月 43 万行。这个量对 ES 是零头,对 H2 也是零头。所以「要不要上时序数据库」这个问题的答案是:现在不需要。
FIG. 08 · 一条指标的一生。整个生命周期里唯一「会思考」的一步只有判阈值和过静默,其余都是搬运,和搬运之后的清理。
十、「房间里的大象」:JVM 之外的邻居
把 Agent 挂进 JVM 很简单。但生产环境很快给我上了第二课。
现在的内网服务器很少有「纯粹的 Java 机器」了。大模型落地后,同一台宿主机上常常挤着 Python(FastAPI、PyTorch、Embedding 检索)、Elasticsearch、Redis,以及业务的 Spring Boot 进程。
某天夜里,一台机器的内存报警响了:96%。
我连进系统查 JVM 监控,堆内存只用了 32%,GC 频率完全正常。Java 进程认为自己健康得很。而真实情况是:旁边跑着的一个 Python RAG 向量抽取进程出现了显存-内存交换泄露,一口吞掉了 24G 物理内存。
一个只看 JVM 内部的 APM,就像一个只量脚趾体温的体温计——房间里站着一头大象,它却视而不见。
但约束依然在:不能装 node_exporter,不能装第三方 Daemon。
0.0.9 版本里,我给采集器加了一把极薄的「手术刀」:Agent 依然在 JVM 内部,但在宿主机告急时,它允许通过标准的 Linux /proc 文件系统向外看一眼,把当前时刻宿主机上最耗资源的 Top 进程拎出来归类:
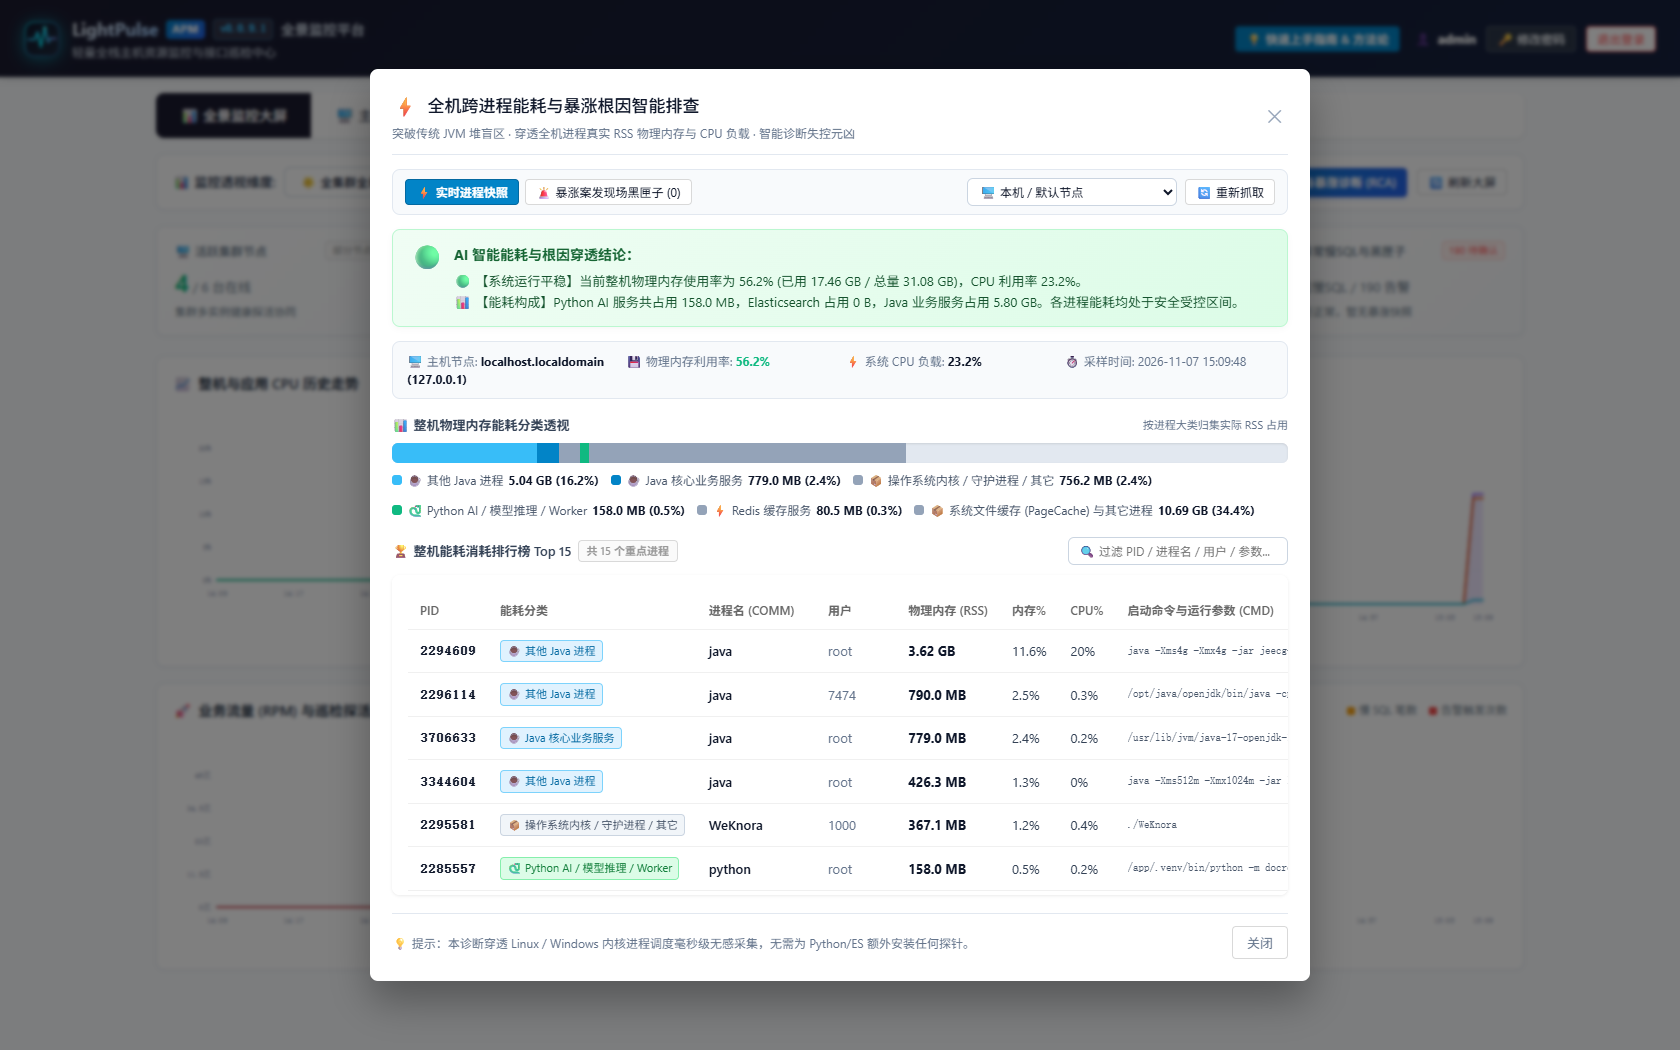
FIG. 09 · 跨进程穿透 RCA。中间圆环图剥开了整台机器的真实切片:Core Java 只占 28%,而旁边的 Python AI 进程吞掉了 46%,内核 PageCache 占 18%。下方按进程树列出 PID、内存绝对用量与启动命令。
谁在偷内存、谁是主犯、谁是被波及的邻居,一眼分明。你不需要再在群里争论是 Java 没调堆大小,还是 Python 脚本写崩了。
十一、「凌晨两点的一秒钟」:案发现场黑匣子
比看不见大象更绝望的,是找不到凶手。
很多生产故障长这样:凌晨 02:14,机器内存冲顶;02:15,Linux 内核的 OOM-Killer 触发,手起刀落把那个吃内存最多的进程枪毙;等到早上 09:00 运维上班连上终端敲 free -m,机器内存只有 38%,一片祥和。
指标曲线上只留下一根尖锐的毛刺,而产生毛刺的那个进程已经灰飞烟灭。翻遍 messages 日志,也只看得到一句冰冷的 Killed process。
监控系统不能只做「事后验尸官」,它必须是「行车记录仪」。
所以在 0.0.9 里,我做了一个叫**案发现场黑匣子(Crime Scene Snapshot)**的机制:
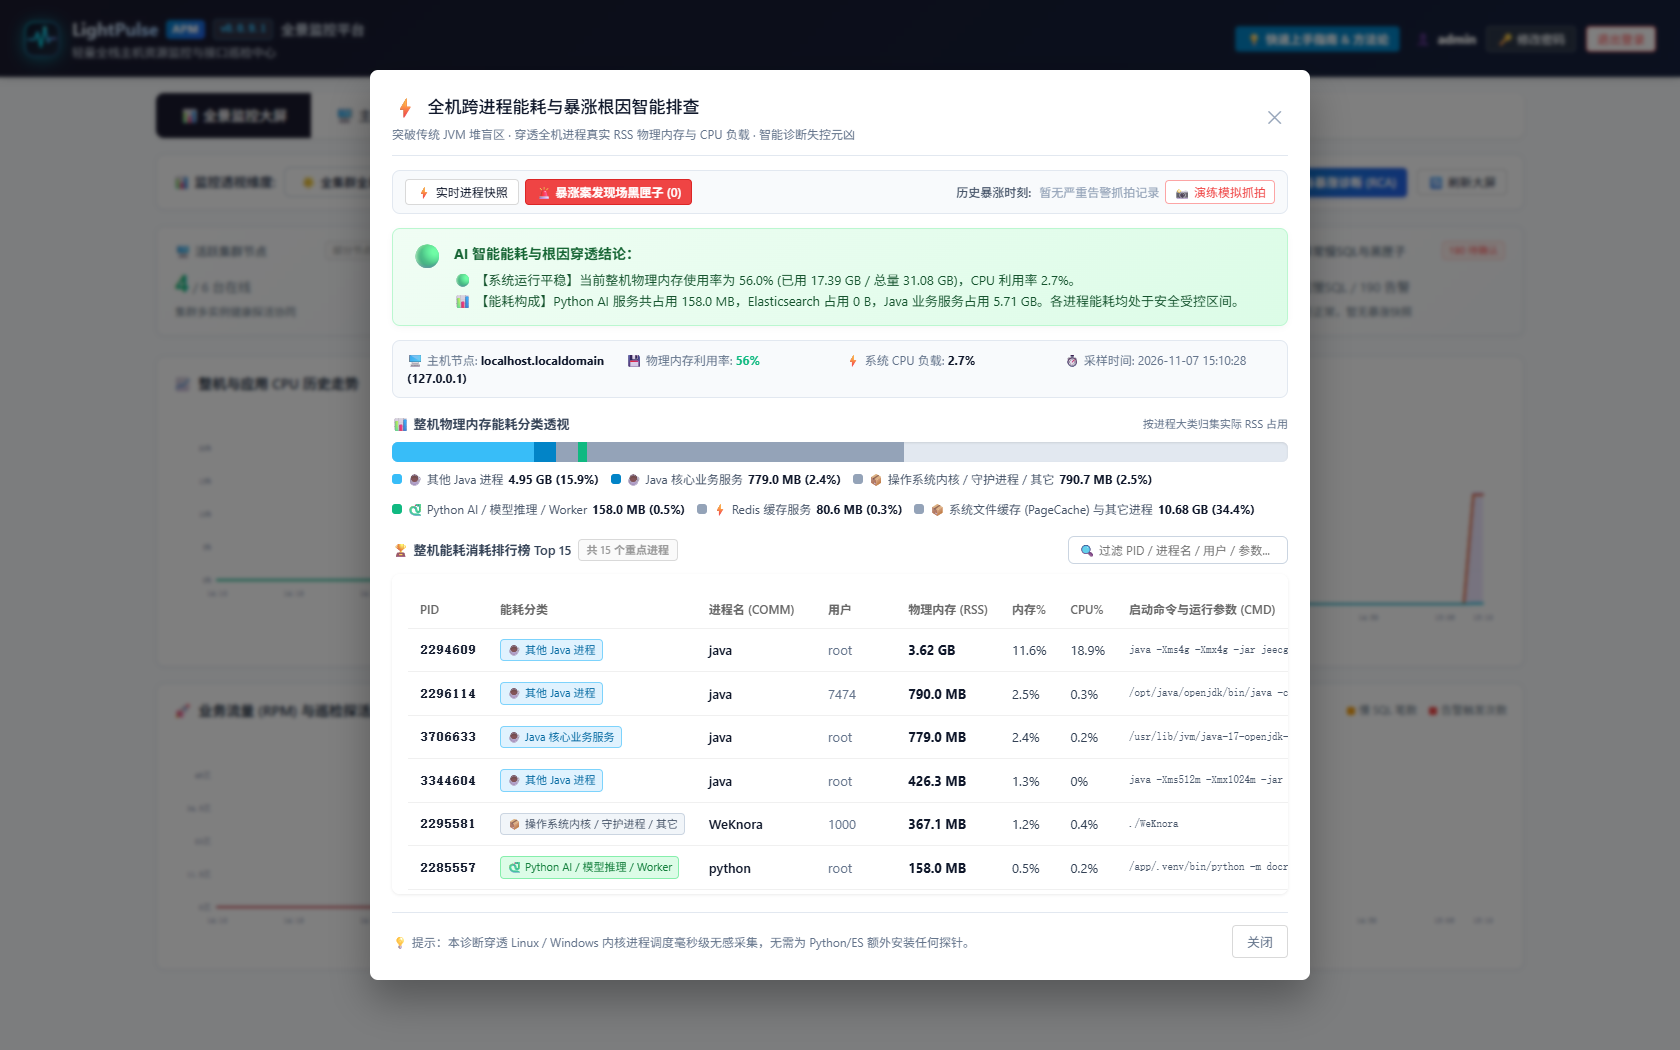
FIG. 10 · 案发现场黑匣子。一旦内存或 CPU 越过 80% 警戒线,探针立刻在微秒级封存当前现场的 Top 15 进程快照。下方是最近 7 次越线现场的历史归档,点击任意一条即可还原当时当地的进程列表。
它不常启动,只在越过红线的一瞬间睁眼,拍照,然后归档进只保留 7 天的时序库里。
第二天早上起来,你不需要去猜昨晚两点发生了什么。点开告警上的快照,当时的 PID、执行命令、内存占比原汁原味地冻结在那里。
十二、从「心跳」到「呼吸」:时序与业务吞吐
探针测的是「心跳」——系统还活着没有。
但在 0.0.9 里,我把心跳往前推了一步,变成了「呼吸」——它现在每分钟处理了多少真实业务请求(RPM / QPS)。
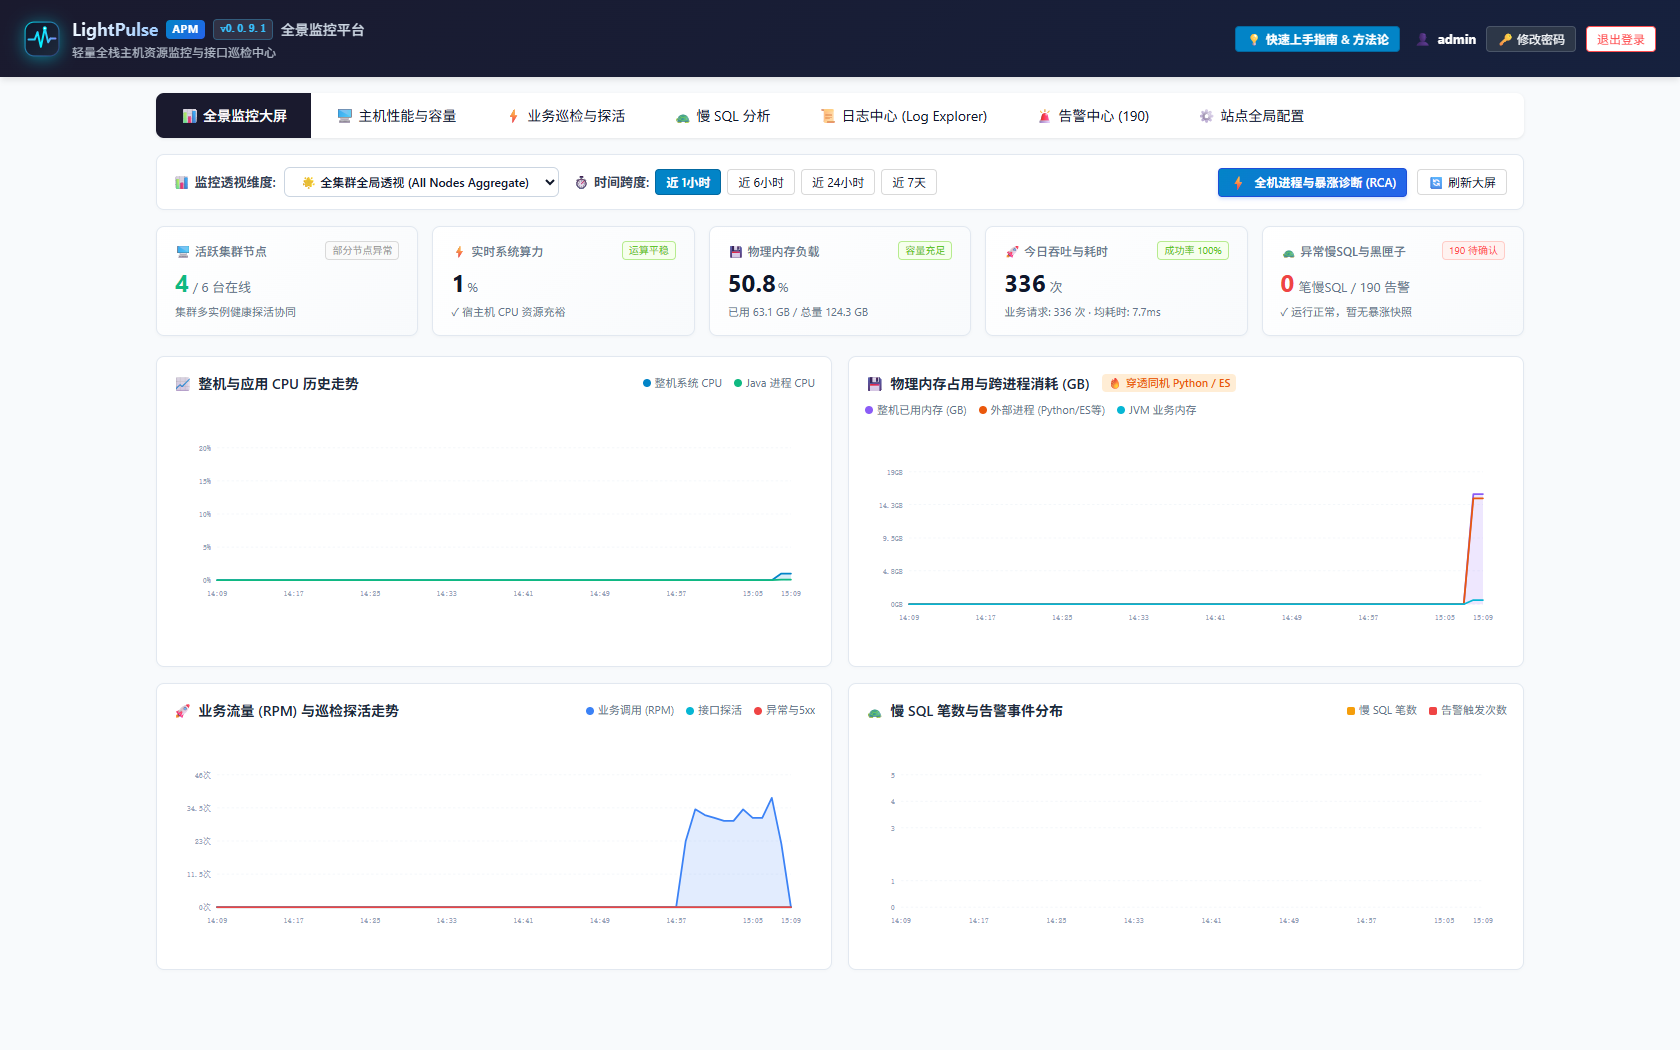
FIG. 11 · 0.0.9 概览时序大屏。左上是全集群 24 小时真实请求吞吐(RPM),波峰波谷清晰可见;右上与左下分别是 CPU 与内存的动态面积堆叠;右下则是多节点存储分区的实时水位监控。
把 RPM(每分钟请求量)和内存曲线叠在一起看,很多悬案会立刻解开:
- 如果内存随着 RPM 升高而升高,那是业务流量,该扩容就扩容;
- 如果凌晨三点 RPM 掉到了零,而内存依然在缓慢上扬,那是代码泄漏,老老实实回去改代码。
不用复杂的 APM 探针字节码注入,通过拦截器的一行非阻塞原子计数,就把业务节奏和系统承载力连在了一起。
十三、我没有做的那件事:预测
README 里我写过「水位分析与提前预警」。这里需要说清楚它现在是什么。
它是一组阈值。磁盘 90%、内存 90%,超了报,没超不报。
它不是预测。我没有做「按当前增速,/data 将在三天七小时后写满」这种曲线外推。
原因不是做不出来——一条线性回归而已。是我不信它。
在一个日均波动一倍的内网里,任何基于几小时窗口的斜率外推,都会在业务高峰前给出一个荒谬的结论。而监控系统最宝贵的资产不是准确率,是运维愿意相信它。一次「预测三天后写满、结果三个月都没满」,就足够让人把整个告警群屏蔽掉。
所以这件事暂时停在「阈值 + 分区全覆盖」。它不聪明,但它说的每一句话,你都能在机器上验证。
十四、轻
回到那个纸筒。
听诊器之所以能留下来,不是因为它比医生的耳朵灵敏,而是因为它让「听」这件事变得可以重复、可以隔着衣服、可以在别人面前做。它把一次私密的、尴尬的、仰赖天赋的动作,变成了一套标准的、克制的、谁都能执行的流程。
我写这套东西的时候,慢慢意识到自己在做同一件事。
不是让运维看得更多,而是让「确认还在正常运行」这个动作变得足够便宜——便宜到可以每 60 秒做一次,便宜到不需要开端口、不需要装插件、不需要一个人守在屏幕前。
一套好的监控,最终应该让人忘掉它存在。
它只是在旁边,安静地听着。
源码在 GitHub,Apache-2.0。两边都能接:独立部署跑 Agent,或者给业务加一行 Starter 依赖。
<dependency>
    <groupId>io.github.chaoking320</groupId>
    <artifactId>monitor-spring-boot3-starter</artifactId>
    <version>0.0.9</version>
</dependency>
源码:github.com/chaoking320/lightpulse-apm(Apache-2.0)
善意·爱 · ShanYi·AI · 上海 · shanyiai.site